
- 2026年5月14日
- 937 view
クマはなぜ街に来るのか?―GISで読み解く東北のツキノワグマ回廊
2023年、東北地方ではツキノワグマによる人身被害が相次いだ。秋田市、盛岡市、仙台市近郊――いずれも……

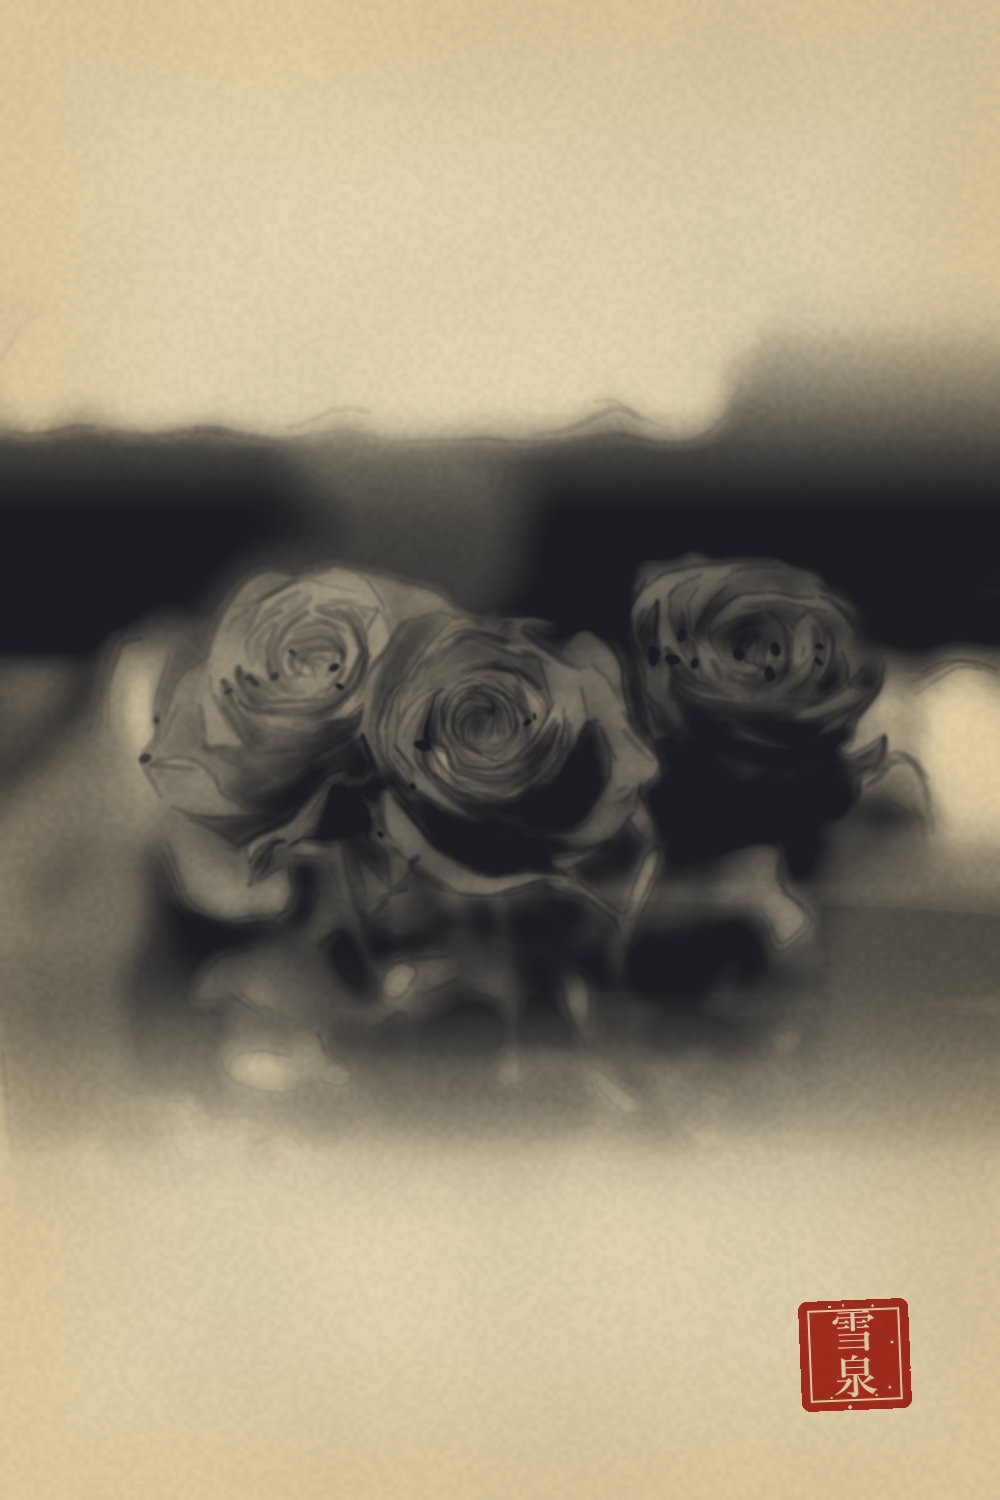
PinterestにSumi-e(水墨画)のピンを上げ始めてから、表示回数が1か月で3倍を超えた。描いているのは筆を持った人間ではない。自作の水墨画エンジン「雪泉」である。
雪泉は、生成AIを一切使わず、筆の線を1本ずつ重ねて水墨画を描くRust製のソフトだ。お手本は室町の雪舟と、桃山の長谷川等伯。本稿では、このエンジンを作る過程でぶつかった3つの壁を書く。「データで巨匠を再現する」という発想が失敗したこと、写真を変換しても絵にはならなかったこと、そしてPythonの遅さからC++ではなくRustを選んだこと。アートとテクノロジーの境目で、何がうまくいき、何がうまくいかなかったかの記録である。
水墨画風の画像を作るだけなら、今は生成AIに頼めば数秒で出てくる。それでも使わなかった理由は、技術的なものより実務的なものだ。
Pinterestは2025年から、AIで生成・修正された画像に「AI修正画像」というラベルを付けている。画像のメタデータを見るだけでなく、目印がなくてもAI生成を自動で見分ける分類ツールも使っている。ピンを拡大表示すると、左下にこのラベルが出る仕組みだ。
ユーザーの側には、AI画像を減らす設定もある。生成AIの画像があふれた反動で、「人が作ったもの」を見たいという需要が高まっているのだ。
せっかく作った作品に「AI修正画像」と付くのは避けたかった。だから、筆の動きも墨のにじみも、すべて自分で書いたプログラムで計算することにした。結果として雪泉の作品は、アルゴリズムで描いてはいるが、AIが描いた絵ではない。
最初に考えたのは、いかにもデータジャーナリズムらしい方法だった。
雪舟と等伯の作品画像を各50枚集め、Pythonで解析する。墨の濃淡の分布、線の太さ、余白の割合といった特徴を数値にして、その「指数」をエンジンのパラメータに入れれば、巨匠の作風が再現できるはずだ。
雪舟の「秋冬山水図」(東京国立博物館蔵、国宝)は、構築的な画面と力強い筆致で知られる。等伯の「松林図屏風」(同、国宝)は、霧の中に浮かぶ松林を墨一色で描いた、日本の水墨画の頂点の一つだ。この二人の数値を混ぜれば、硬い骨格と柔らかい霞を両立できる、と考えた。
結果は、まったくだめだった。
解析した指数をそのまま入れても、出てくる画像は雪舟にも等伯にも見えない。数値としては平均的な特徴を写しているのに、絵としての緊張感が消えてしまう。
いま振り返ると、理由はおそらく次の2つだ。
最終的に、パラメータはすべて自分の目で見ながら独自に決めた。墨の締め、余白、葉の密度、刷毛の筋。作品ごとに出来上がりを見て、数値を動かしては描き直す。データで巨匠を写すのではなく、データを捨てて自分の目を基準にしたところから、ようやく水墨画らしくなった。
仮説検証という意味では、「巨匠の作風は統計で再現できる」という仮説は棄却された。それ自体が、この開発で得た一番の発見だったかもしれない。
最初の版は、写真を水墨画風に変換するものだった。輪郭を抽出し、濃淡を墨の階調に置き換え、和紙の質感を重ねる。それなりに見栄えはする。
しかし、どこまで調整しても「画像は画像。絵にはならない」という壁を越えられなかった。写真の変換は、写真にある情報を並べ替えているだけだ。画家が描く絵は、何を描き、何を描かないかを選んでいる。その「選択」がない限り、どれだけ質感を似せても絵には見えない。
そこで、写真変換版は残したまま、まったく別の「筆描き版」を作った。画面を一括で加工するのではなく、筆の線を1本ずつ重ねて描いていく方式だ。
意外だったのは、人物の扱いだ。筆描き版で人物を描くと、最初はうまくいかなかった。最終的に納得できたのは、作風を等伯側に振り切り、刷毛で面を塗る淡い灰色を最大にした設定だった。輪郭で人を描くのではなく、霞の中に人が立っているように描く。松林図の描き方が、人物にも効いたことになる。
[画像:筆描き版の風景と人物の比較]
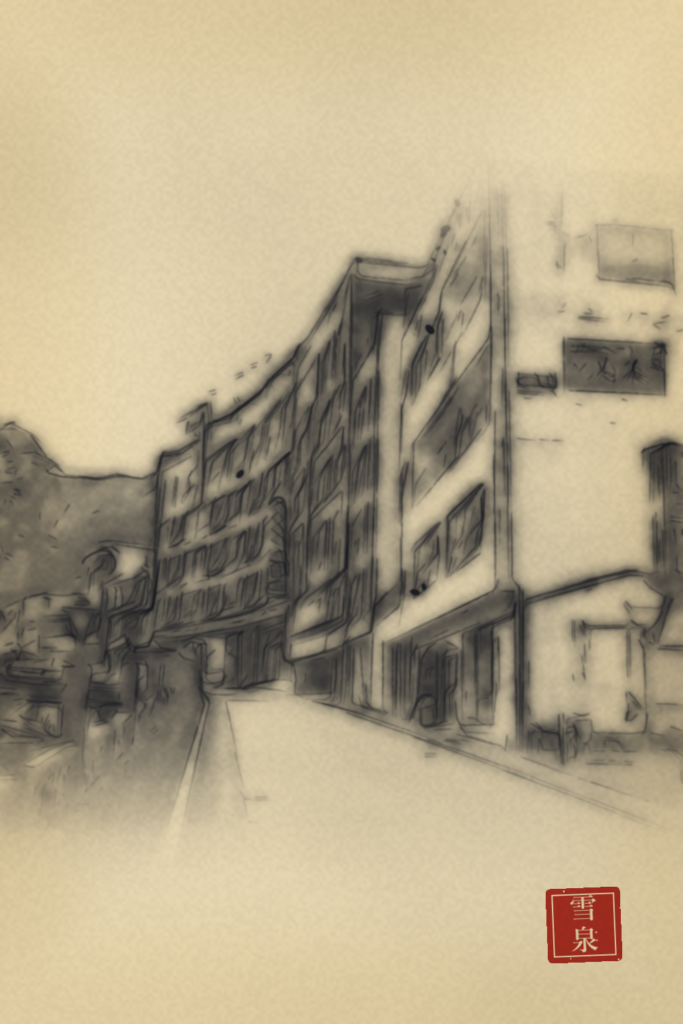
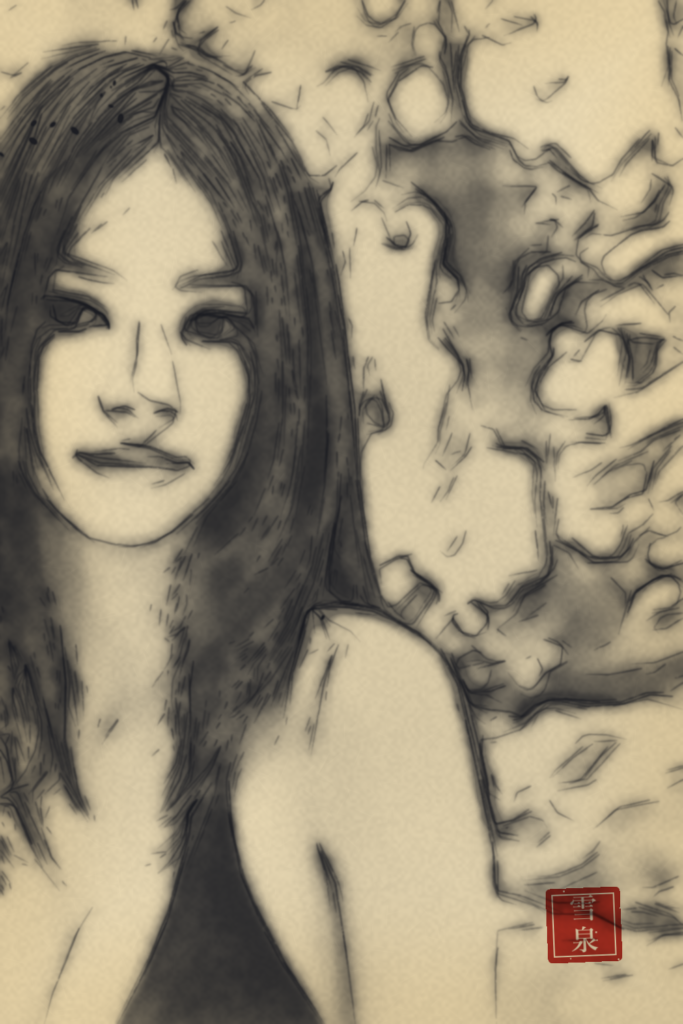
水墨画らしさを決めるもう一つの要素が、にじみだ。和紙に落ちた墨は、繊維に沿ってじわりと広がる。この広がりを、雪泉ではブラウン運動で計算している。
ブラウン運動は、水に浮かんだ微粒子が水の分子にぶつかって、でたらめに動き回る現象だ。墨の粒子を1つずつ、でたらめな方向に少しずつ動かしていくと、輪郭のまわりに自然なにじみが生まれる。
雪泉では、この「にじみ生成エンジン」に2つの濃さを用意した。
| 設定 | 用途 |
|---|---|
| 15倍希釈 | 標準のにじみ。輪郭のまわりに墨がにじむ |
| 30倍希釈 | 霞・雲のレイヤー。画面に空気を入れる |
気に入っているのは、細くしっかりした輪郭線を残したまま、そのまわりだけをにじませる表現だ。線の強さとにじみの柔らかさが同時に出ることで、雪舟の骨格と等伯の霞を一枚の中で両立できるようになった。
筆を1本ずつ重ね、墨の粒子を1つずつ動かす。この方式は、計算量が非常に多い。
開発はPython(Anaconda環境)で始めたが、筆描き版とにじみエンジンを組み込んだ段階で、1枚のレンダリングに約10秒かかるようになった。
10秒は、一度だけなら待てる。しかし、この開発は「数値を少し動かしては描き直す」作業の繰り返しだ。第1の壁で書いたとおり、パラメータは自分の目で決めるしかない。1回の試行に10秒かかると、試せる回数が限られ、感覚で詰めていく作業が成り立たない。
速い言語で書き直すしかない。最初に候補にしたのはC++だった。
画像処理の世界では、速さが必要ならC++というのが長く定番だった。OpenCVをはじめ、資産も情報も多い。それでも最終的にRustを選んだ。
調べていくうちに、二つのことがわかった。一つは、速度はC++とRustでほぼ同等だということ。どちらもPythonのようなインタプリタを介さず、機械語に直接コンパイルされる。ガベージコレクション(不要なメモリを自動で回収する仕組み)で処理が止まることもない。
もう一つは、C++ではメモリの扱いを手で書く必要があり、わずかな書き違いでデータが壊れるということだ。メモリを確保し、使い、解放する。その手順が少しでも曖昧だったり間違っていたりすると、プログラムは動いているように見えて、ある時突然クラッシュしたり、気づかないうちに画像が崩れたりする。C++の規格はこうした状態を「未定義動作」と呼び、何が起きても保証しない。
ここでいう「メモリ」は、PCに積まれているメモリ(RAM)のことだ。ただし問題は容量ではなく、RAMのどの場所をどう使うかの管理にある。
RAMを作業机にたとえるとわかりやすい。プログラムは、画像や筆の線のデータを広げるために、机の一角を借りる。「この区画を使います」と場所を押さえ(確保)、データを書き込んで使い、使い終わったら返す(解放)。C++では、この借りる・返すを、書き手が自分でコードに書く。
C++では、区画の端を越えていないかを確かめるのは書き手の仕事で、確かめなければプログラムは黙って書き込んでしまう。
速さが同じなら、壊れにくいほうを選ぶ。これが決め手だった。つまり違いは、速さそのものではなく、速さを出すまでの「作りやすさ」と「壊れにくさ」にある。
| Python | C++ | Rust | |
|---|---|---|---|
| 実行速度 | 遅い(インタプリタ) | 速い | 速い |
| メモリの安全性 | 自動管理 | 書き手の責任 | コンパイラが検査 |
| 並列処理 | GILの制約がある | 可能だが競合のバグが出やすい | 競合をコンパイル時に防ぐ |
| ビルドとライブラリ管理 | pip/conda | CMakeなど、環境ごとに設定が必要 | Cargoで統一 |
| 配布 | 実行環境ごと必要 | exe化できる | 単体のexeにしやすい |
雪泉にとって効いたのは、次の3点だ。
1. メモリの安全性をコンパイラが保証する
C++では、確保したメモリの解放忘れや、解放済みのメモリへのアクセスといったバグを、書き手が自分で防ぐ必要がある。現代のC++にはスマートポインタのように安全に書くための道具もあるが、使うかどうかは書き手次第で、危ない書き方も変わらず許されている。筆の線や墨の粒子を大量に生成しては消すエンジンでは、こうしたバグが起きやすい。
Rustは「所有権」という仕組みで、メモリを誰が持ち、いつ解放されるかをコンパイル時に検査する。危ないコードは、そもそもコンパイルが通らない。作業机のたとえで言えば、どのデータが机のどこを借りていて、いつ返すのかを、コンパイラが先に全部確かめてくれる。配列の範囲を越えて書き込もうとした場合も、その場で処理を止め、データを壊させない。実行してから原因不明のクラッシュに悩む時間が、ほぼなくなる。
2. 並列処理を安全に書ける
計算を速くする一番の近道は、CPUの複数のコアで同時に計算させることだ。ただ、複数の処理が同じデータを同時に書き換えると、結果が壊れる(データ競合)。C++ではこれも書き手の注意に任されている。
Rustでは、データ競合が起きうるコードはコンパイル時にエラーになる。画面を区切って並列に描く、粒子をまとめて動かす、といった処理を、壊れる心配をせずに書ける。
3. Cargoで環境構築に悩まない
Windowsで、画面付きのソフトをC++で作ろうとすると、コンパイラの準備、CMakeの設定、ライブラリの導入で手間がかかる。RustはCargoという公式のツールが、ライブラリの取得からビルドまでをまとめて引き受ける。数行の設定で、画面付きの単体のexeが出来上がった。
結果:
Rustで書き直した雪泉は、画像を入れた瞬間にレンダリングが終わる。Python版で約10秒かかっていた待ち時間が、事実上ゼロになった。待ち時間が消えたことで、パラメータを感覚で詰める作業が、ようやく「描く」作業に近づいた。
速さは単なる効率ではない。試行の回数を増やし、目で判断できる回数を増やす。アートの開発にとって、速さは表現の質そのものに直結していた。
書き直してから気づいたことがある。同じ写真から描いても、Rust版のほうが墨の粒子がきめ細かいのだ。
[画像:同じ写真をPython版(左)とRust版(右)で描いた比較]
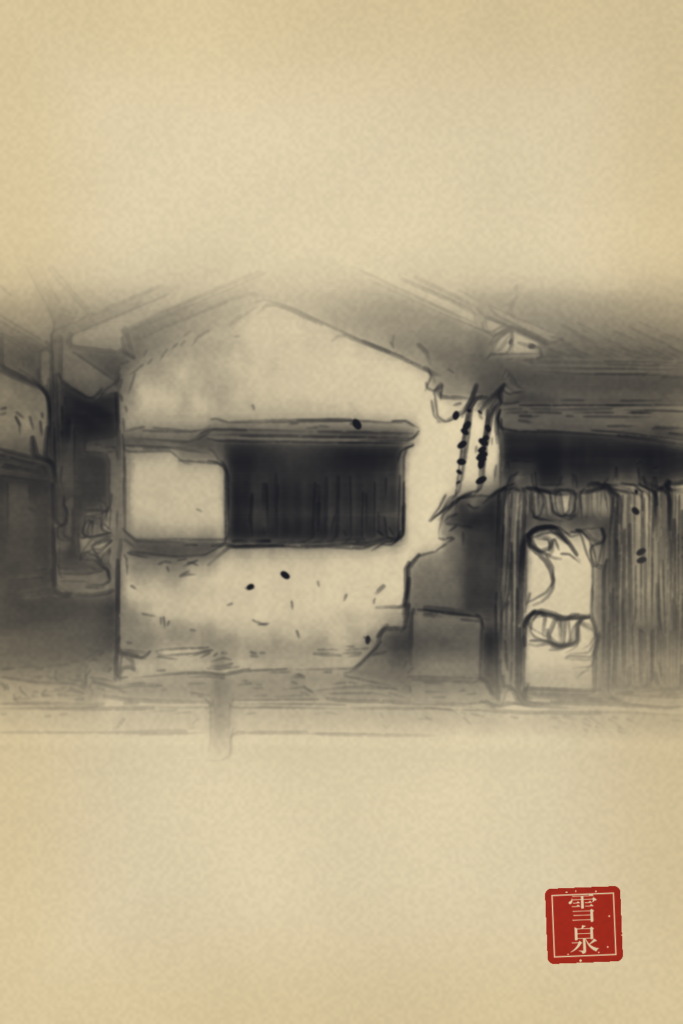
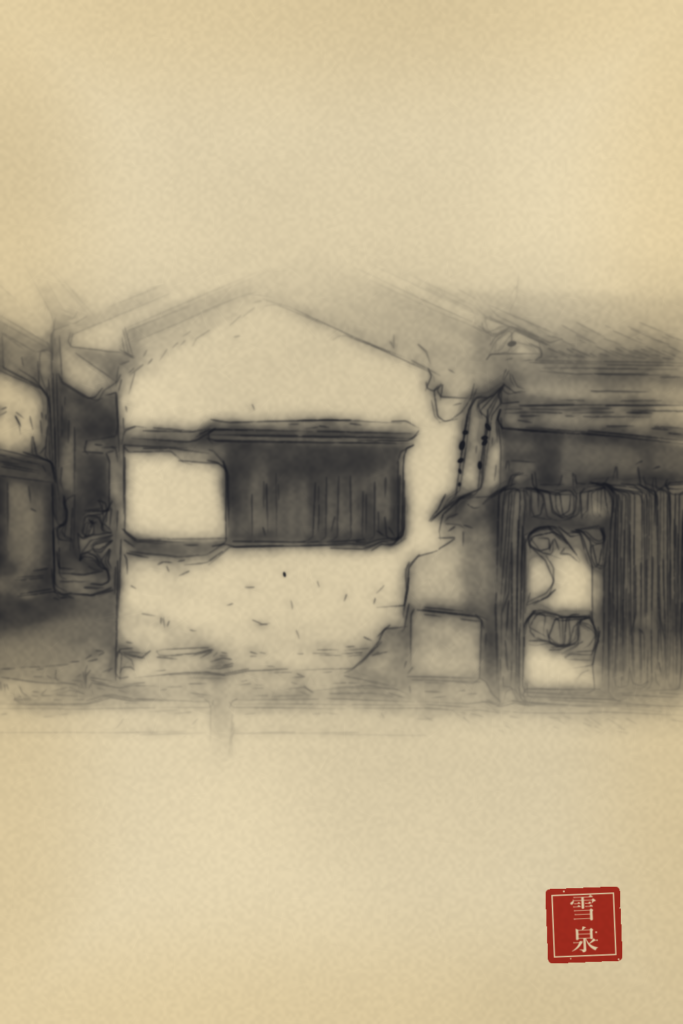
見た目の印象を確かめるため、2枚を数値で比べた。描画部分(縦1500pxのうち400〜1100px、落款を除く)で、周囲より一定以上濃い墨の点や線を「痕跡」として数えた。
| Python版 | Rust版 | |
|---|---|---|
| 濃い痕跡の数 | 213個 | 271個 |
| 痕跡の大きさ(中央値) | 24px | 15px |
| 大きい痕跡(上位10%) | 174px | 114px |
| 真っ黒に近い部分の割合 | 12.9% | 7.3% |
Rust版は、痕跡の数が約3割多く、一つひとつは約4割小さい。墨を細かい粒で、たくさん置いていることになる。
原因はまだ確かめていないが、候補は二つある。一つは、速くなった分だけ、動かす粒子の数や反復の回数が増えたこと。もう一つは、粒子の位置を整数のピクセルに丸めず、小数の座標のまま描くようになったことだ。どちらも、粒を小さく、多くする方向に効く。なお、Pythonの小数とRustでよく使う小数(f64)はどちらも64ビットの倍精度で、計算の精度そのものに差はない。違いが出るとすれば、精度ではなく、小数を途中で捨てているかどうかである。
一方で、失ったものもある。Rust版は真っ黒な部分がPython版の約半分で、全体に墨が軽い。Python版の窓まわりの深い黒や、ぽつりと落ちた墨の点には、水墨画らしい重さがあった。きめ細かさと墨の深みをどう両立させるかは、次の課題として残っている。
速さは単なる効率ではない。試行の回数を増やし、目で判断できる回数を増やす。そして、計算できる粒子の数そのものを変える。アートの開発にとって、速さは表現の質そのものに直結していた。
雪泉の開発で残った教訓は、技術が万能ではなかったことだ。
一方で、技術がなければ届かなかったこともある。ブラウン運動でにじみを計算し、Rustの速さで何百回も描き直せたからこそ、目で判断する作業が成り立った。
テクノロジーは絵を描いてくれるわけではない。絵を描くための試行錯誤を、人間が回せる速さにしてくれる。アートとテクノロジーの融合とは、おそらくその分担のことなのだと思う。
雪泉の作品は、Pinterestのボード「Sumi-e Japanese Ink Wash|雪泉の水墨画」で公開している。
Googleの検索結果で、当サイトの記事を見つけやすくなります。
2023年、東北地方ではツキノワグマによる人身被害が相次いだ。秋田市、盛岡市、仙台市近郊――いずれも……
本記事は、BBC News(2026年2月20日)の “The Chinese AI app sen……
Photo by TechCrunch / CC BY 2.0